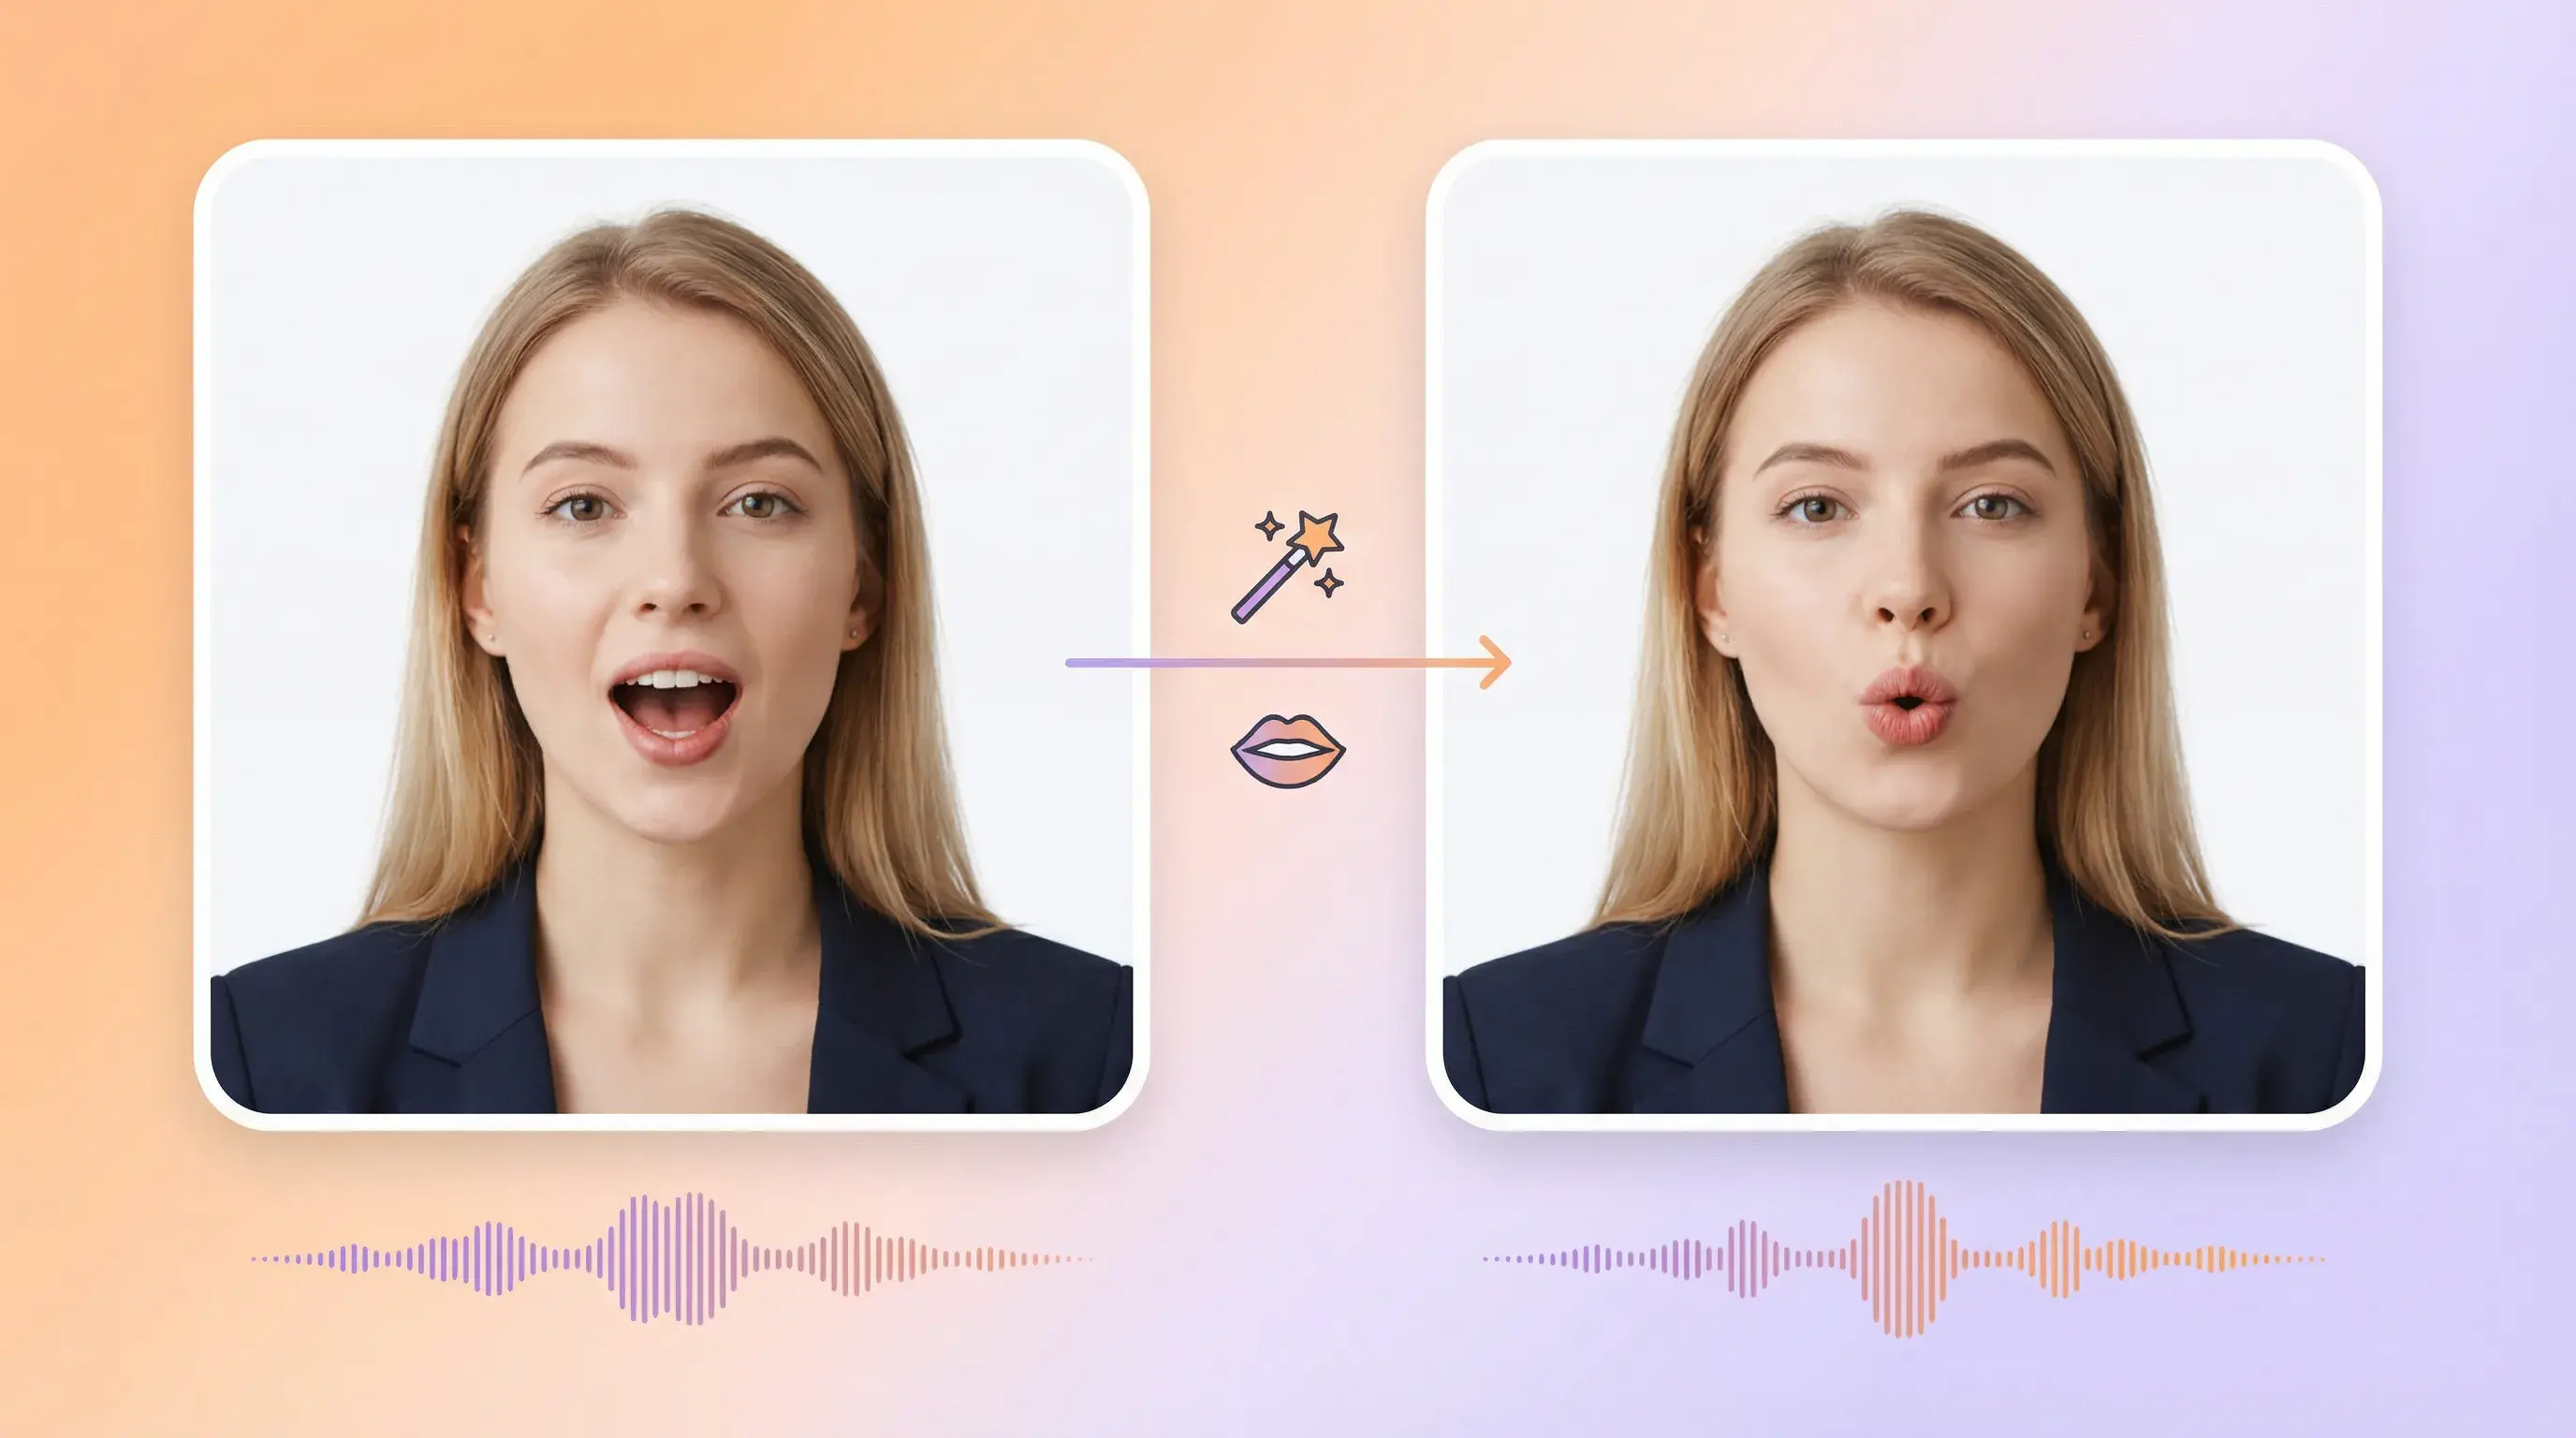
上传人像照片与配音音频,生成对口型的口播视频。可作为广告素材与产品讲解的起点,发布前先审核生成结果。
上传人像照片和准备好的配音音频,生成口播视频。
人像照片 + 配音音频 → 一段对口型的口播视频。人像是画面输入,音频提供说话内容和节奏;用于投放前请先审核生成结果。
上传一张清晰的人像,或选择可用的示例人像。
上传你希望人像说出的配音。
在工作台启动任务,处理完成后审核生成的视频。
准备好人像与配音,再审核生成的视频。
以你的配音作为口型时间的依据。审核生成视频的同步与清晰度。
用一张静态人像照片生成说话视频。逐条审核结果中的面部呈现与动作。
在生成视频前,先准备好具备所需语气的配音。
上传前,在配音中设定好语速与停顿。
把人像照片与配音音频组合起来,提交一次口型同步任务。
同一张源人像搭配不同音频,生成多个版本。选定版本前逐一审核结果。
比较输入与准备步骤
以人像为主体生成口播片段,作为广告创意审核的草稿。
为每个市场分别准备音轨,并审核每个生成版本。
用准备好的旁白生成以人像为主体的产品讲解草稿。
AI 口型同步
一张人像照片和准备好的配音音频。照片支持 JPG 或 PNG,大小不超过 10 MB,不支持 WebP 和 GIF。上传的音频支持 MP3、WAV、M4A、AAC,时长不超过 10 分钟;为保证稳定上传,建议文件保持在 50 MB 以内。你也可以用文字转语音(TTS)从不超过 500 字符的台词生成配音。
工具根据你的音频生成口型动作。使用视频前,先审核结果中的口型时间与面部呈现。
上传前在配音中准备好语气、语速和停顿。当前网页流程没有单独的「角色表演」(Character Performance)设置项。
复用同一张源人像,为每个版本上传不同音频。分别提交并逐一审核结果。
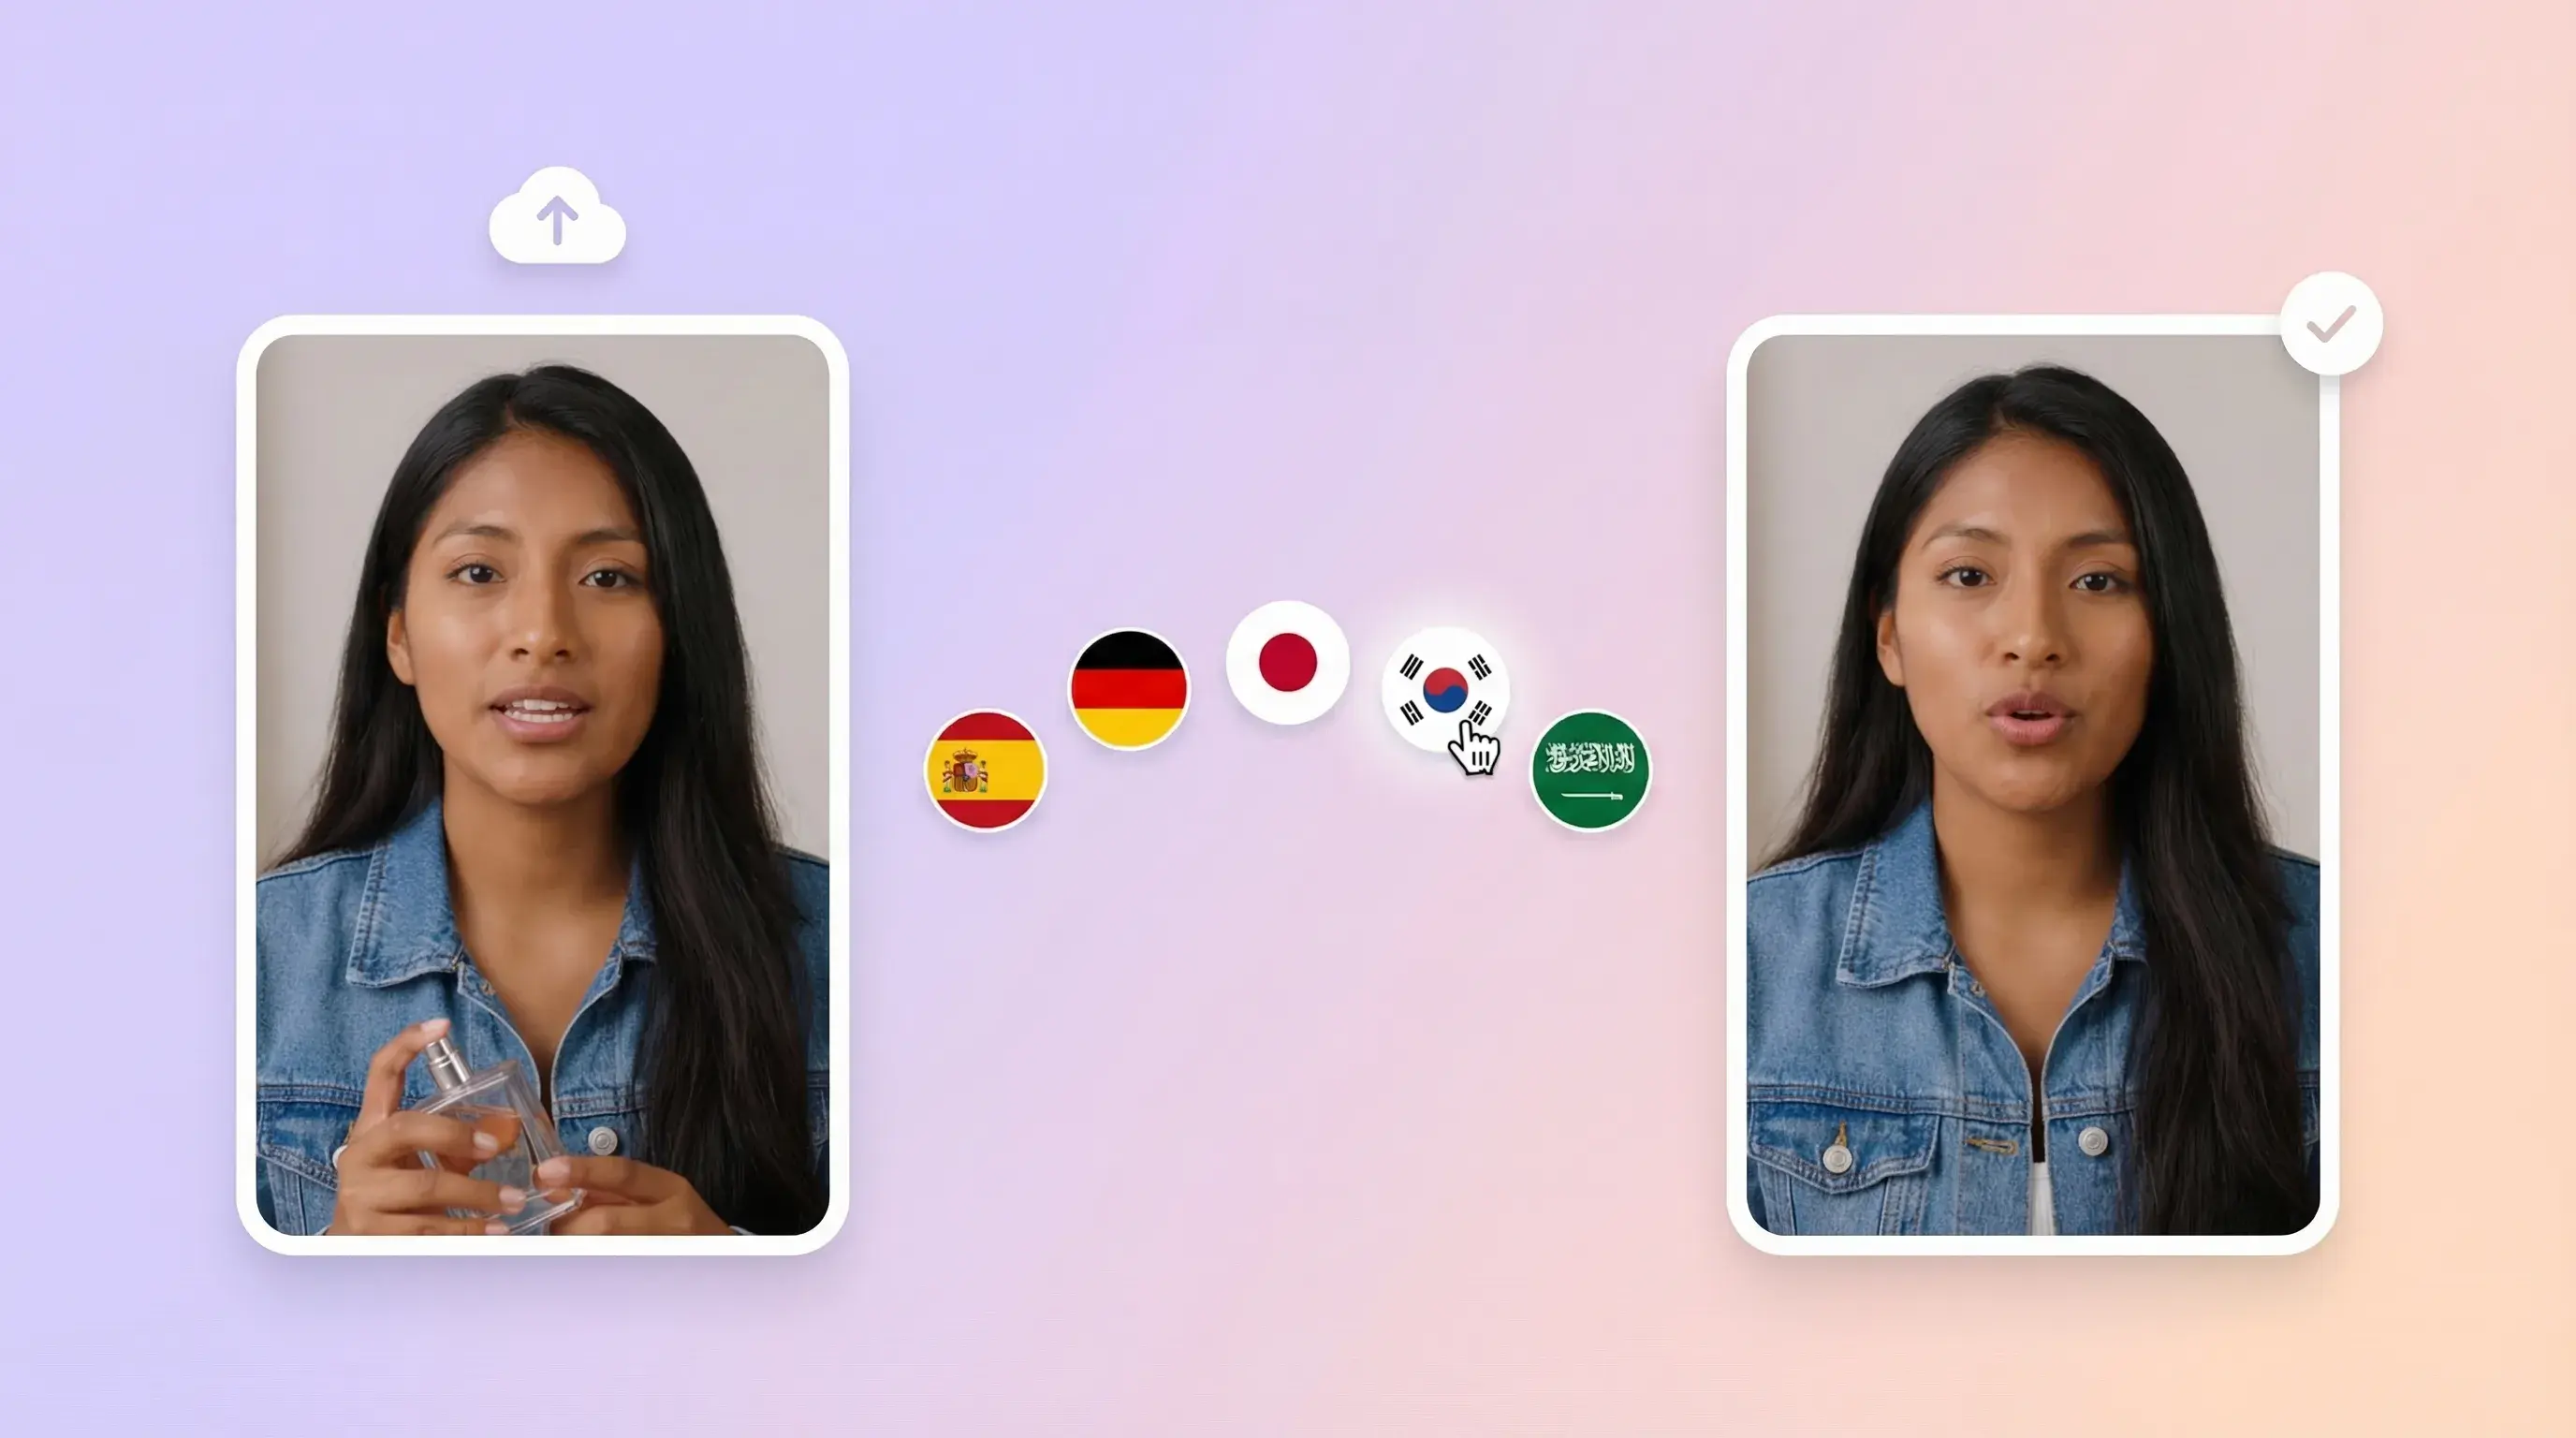
为每种目标语言准备配音音频,用同一张源人像再提交一个版本。如需翻译已有视频,可使用视频翻译。
可以。使用文字转语音(TTS)功能,从不超过 500 字符的台词生成配音音频。TTS 免费,且不受套餐等级限制。视频生成当前按音频时长计费,每秒 24 积分。
视频生成当前按音频时长计费,每秒 24 积分。TTS 免费;生成失败会返还积分。没有免费试用。提交前请在工作台查看预估消耗。
生成以任务形式处理。可在工作台查看任务状态,完成后审核结果。
生成结果显示在 Project 页面,分辨率为 1080p。视频比例跟随上传的图片,不包含字幕。投放前请先审核结果。需要为片段添加字幕?可使用视频字幕。
不可以。本页介绍的网页端和 API 流程都从一张人像图片开始。如需翻译已有视频,可使用视频翻译。
准备好人像与音频,打开工作台,发布前审核生成结果。
 AdsTurbo